Unlock Premium Resources
Ready to explore faklum?
Sur faklum, améliorer vos performances ne veut pas dire “changer pour changer”. Cela signifie observer ce qui compte, quantifier l’impact de chaque décision, puis itérer avec méthode jusqu’à obtenir des résultats mesurables. Dans la pratique, tout se joue entre trois piliers : choisir les bons KPIs, exécuter des tests A/B fiables, et transformer les apprentissages en itérations concrètes.
Ce guide se concentre sur un objectif précis : vous aider à structurer votre boucle d’amélioration en restant pragmatique. Vous repartirez avec une méthode actionnable pour passer de “nous pensons que…” à “nous savons que…”, sans alourdir votre organisation ni perdre du temps dans des analyses inutiles.
Définir une stratégie KPI centrée sur vos objectifs business
Avant de mesurer quoi que ce soit, clarifiez votre objectif principal : plus de conversions, une meilleure rétention, une augmentation du revenu, ou encore une réduction des abandons. Sans cette boussole, vos KPIs deviennent une liste de chiffres, sans lien direct avec la performance réelle. L’idée n’est pas d’avoir “le plus de métriques possible”, mais de sélectionner celles qui répondent à des questions précises.
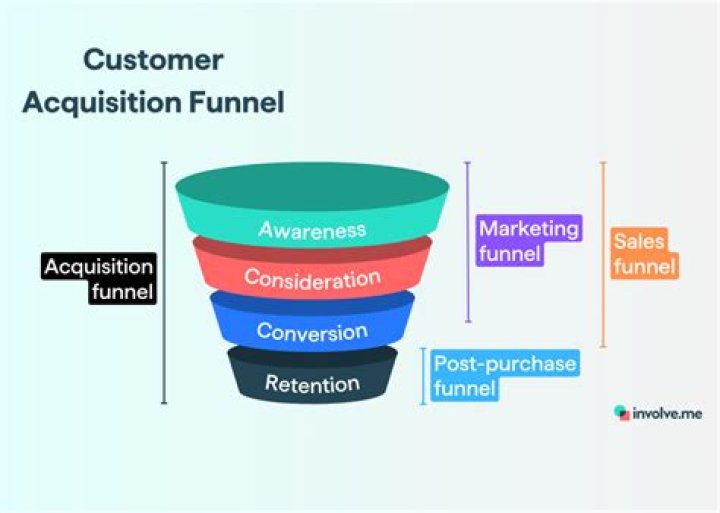
Sur le plan sémantique, pensez votre dispositif KPI comme un entonnoir (funnel) : acquisition, activation, engagement, conversion, puis fidélisation. Chaque étape correspond à des décisions différentes. Par exemple, si votre problème est l’activation, les métriques “trafic” ne suffisent pas : il faut regarder le comportement post-visite (délai de première action, taux d’activation, profondeur de parcours).
Ensuite, distinguez les indicateurs de pilotage (ceux que l’on peut influencer rapidement) des indicateurs de résultat (ceux qui reflètent le gain final, parfois avec un décalage). Cette séparation évite une erreur fréquente : optimiser une métrique intermédiaire qui bouge, mais qui n’améliore pas le résultat global. En bref, vos KPI doivent être à la fois actionnables et alignés sur le business.
Pour ancrer votre sélection, posez-vous trois questions à chaque KPI :
- Le KPI répond à une décision concrète ? Si non, il risque d’être un bruit de fond.
- Le KPI est mesurable avec une précision suffisante ? Sinon, vous testerez sur des variations invisibles.
- Le KPI est relié à une valeur business ? Sans lien, vous optimisez localement.
Exemples de KPIs par étapes : de l’intention à la valeur
Selon votre cas, votre “point de douleur” se situe rarement au même endroit. Voici comment structurer des KPIs pertinents par étape, en restant général pour couvrir les usages courants.
Acquisition : taux de clic, coût par acquisition (si vous gérez des campagnes), part de trafic qualifié. Attention : un bon volume d’audience n’implique pas une bonne performance si la qualité n’est pas au rendez-vous.
Activation : taux d’activation, proportion d’utilisateurs qui réalisent la première action utile, temps avant la première valeur. Ici, l’enjeu est de réduire la distance entre l’arrivée et le “moment aha”.
Engagement : fréquence d’usage, durée de session, récurrence des actions clés, taux d’exploration. Ces métriques servent souvent à détecter une friction : une expérience qui “fonctionne” mais n’incite pas à revenir.
Conversion : taux de conversion, taux d’abandon par étape, valeur moyenne par conversion, conversion segmentée (nouveaux vs récurrents, canaux, device). Le test A/B doit se baser sur des indicateurs qui changent avec vos modifications.
Fidélisation : rétention à J7 J30 (ou vos fenêtres), churn, LTV (si vous la calculez), taux de réactivation. La performance long terme se voit ici ; elle ne doit pas être sacrifiée pour un gain court terme.
Construire un tableau de bord “pilotable” et éviter les pièges de mesure
Un tableau de bord n’est utile que s’il accélère vos décisions. Si vos KPI sont dispersés, si les définitions changent, ou si les données arrivent trop tard, vous finissez par piloter “au ressenti”. Sur faklum, l’enjeu est de disposer d’un cadre cohérent : définitions fixes, segmentation claire et lecture rapide.
Commencez par harmoniser les définitions. Par exemple, clarifiez ce que signifie “conversion” : à quel moment, sur quelle action, pour quel périmètre. De même, évitez d’utiliser des métriques “à interprétation variable” (ex. “performance globale”) qui compliquent l’analyse lors d’un test A/B.
Puis, mettez en place une structure de lecture : “ce qui a bougé”, “pourquoi ça a bougé”, “que fait-on maintenant”. Un bon tableau de bord affiche aussi des contrôles de qualité : volume de trafic suffisant, cohérence des événements, et stabilité des segments.
Segmentation : le raccourci le plus rentable pour comprendre l’impact
Si vous analysez uniquement le global, vous masquez souvent des effets opposés. Un changement peut améliorer la performance pour un segment (nouveaux utilisateurs) tout en la détériorant pour un autre (utilisateurs récurrents). La segmentation réduit ce risque et améliore la pertinence de vos itérations.
Les segmentations les plus utiles sont généralement :
- Source ou canal : acquisition vs direct, campagne, recommandation.
- Device : mobile, desktop, tablette.
- Étape comportementale : nouvel arrivant, utilisateur activé, utilisateur engagé.
- Cadence : fréquence d’usage, ancienneté, jours depuis la première action.
Une règle pratique : avant d’interpréter un test A/B, regardez si les distributions des segments sont comparables entre les variantes. Cela évite d’attribuer un changement à un effet produit alors que c’est un effet d’audience.
Tests A/B fiables : la méthodologie qui rend vos décisions crédibles
Les tests A/B sont le moyen le plus direct de relier une modification à un résultat. Pourtant, beaucoup de tests échouent non pas parce que les idées sont mauvaises, mais parce que le protocole est fragile. Un test A/B fiable repose sur la comparaison équitable, l’adéquation du métrique, et la gestion du hasard.
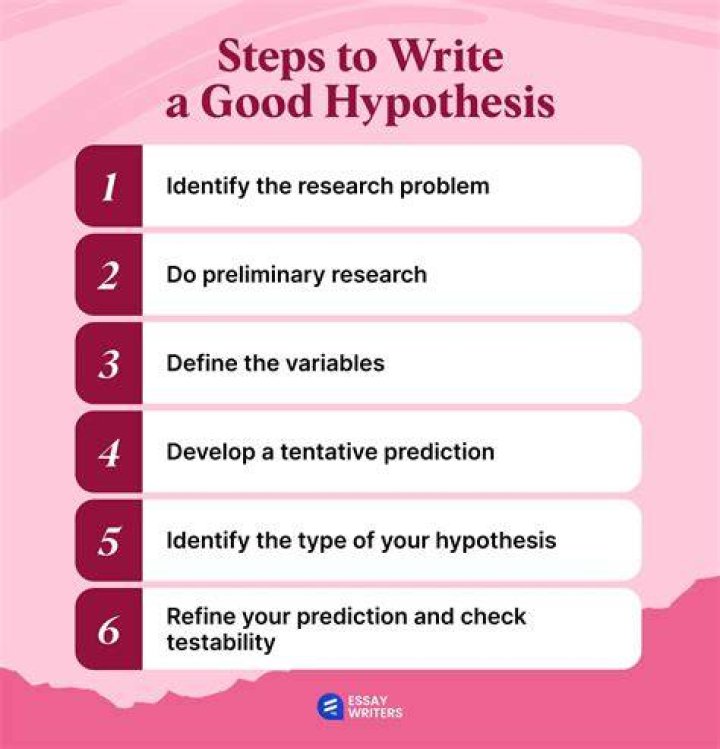
La première étape consiste à définir une hypothèse testable. Évitez les formulations vagues du type “on pense que ça va mieux marcher”. Préférez : “Si on réduit le temps avant la première action utile, alors le taux d’activation augmentera, ce qui améliorera la conversion finale”. Ici, vous reliez explicitement l’action au KPI cible.
Ensuite, choisissez le KPI principal (primary metric) et éventuellement un ou deux KPI secondaires. Le principal KPI sert de boussole ; les secondaires servent à détecter les effets de bord. Cette discipline limite le “cherry picking” inconscient.
Choisir la bonne métrique d’impact : éviter le faux positif
Le KPI principal doit refléter votre objectif central. Si votre objectif est la conversion, mesurer uniquement le clic ou l’engagement de surface peut produire un faux positif : vous améliorez l’intérêt mais pas l’action utile. À l’inverse, mesurer un KPI trop “lointain” peut retarder l’apprentissage et rendre le test trop long.
Une approche robuste consiste à choisir un KPI “court terme” fortement corrélé au KPI long terme. Par exemple, un changement qui améliore l’activation a souvent un effet ensuite sur la conversion. Cette logique rend le cycle d’itération plus rapide sans perdre le lien avec la valeur.
Durée, taille d’échantillon et contrôle des segments
Un test A/B trop court peut vous tromper : vous observez un bruit statistique et vous concluez trop vite. À l’inverse, un test trop long ralentit votre boucle d’amélioration. La bonne durée dépend de la volumétrie et du taux de conversion attendu. L’important est d’obtenir une quantité de données suffisante pour que la différence soit interprétable.
Le contrôle de l’audience est tout aussi critique. Sur une expérience, les utilisateurs n’arrivent pas tous au même moment ni avec la même intention. Assurez-vous que la randomisation répartit les utilisateurs sur les variantes de façon stable, et vérifiez que les segments clés restent comparables.
Gérer les effets de bord : ce que vos KPI secondaires doivent raconter
Un test A/B peut améliorer un KPI principal tout en dégradant un autre aspect essentiel. Par exemple, une modification peut réduire les abandons et augmenter la conversion, mais aussi augmenter le support nécessaire ou diminuer l’engagement long terme. C’est exactement le rôle des KPI secondaires : détecter ces effets de bord.
Pour rester efficace, limitez le nombre de KPI secondaires. Trop de métriques augmente le risque d’observer des variations “au hasard” et de sur-interpréter. Choisissez des KPI secondaires qui ont une relation logique avec l’expérience.
Itérations : transformer les résultats en améliorations concrètes
Après un test A/B, la question n’est pas “avons-nous gagné ?” seulement. La question est “que faisons-nous maintenant et pourquoi ?”. Une itération réussie dépend d’une interprétation structurée des résultats, puis d’une priorisation cohérente des prochains changements.
Sur faklum, l’itération doit suivre une logique d’apprentissage. Si la variante gagnante augmente le KPI principal, vous pouvez soit consolider la solution, soit chercher à optimiser davantage un facteur identifié. Si le test est neutre, vous ne perdez pas : vous avez appris que l’hypothèse n’était probablement pas la meilleure ou que la modification n’était pas assez ciblée.
Enfin, si la variante est perdante, analysez les raisons possibles : mauvais KPI cible, audience déséquilibrée, ou modification qui crée une friction. La performance n’est pas un jugement de valeur, c’est un signal. Les itérations transforment ce signal en progrès.
Rédiger un “retour d’expérience” actionnable après chaque test
Pour éviter que les tests s’accumulent sans progrès, consignez systématiquement trois éléments : l’hypothèse, la stratégie de test (variantes, KPI principal, durée, segmentation), et la conclusion orientée décisions. Ce format rend les discussions d’équipe plus rapides et plus factuelles.
Ensuite, reliez les résultats à des décisions :
- Adopter la variante gagnante et documenter l’impact.
- Répéter avec une version plus ciblée (par exemple une variante 2).
- Reformuler l’hypothèse si les KPI n’évoluent pas.
- Abandonner l’idée si les effets de bord sont trop coûteux.
Prioriser le backlog d’expérimentations avec une logique simple
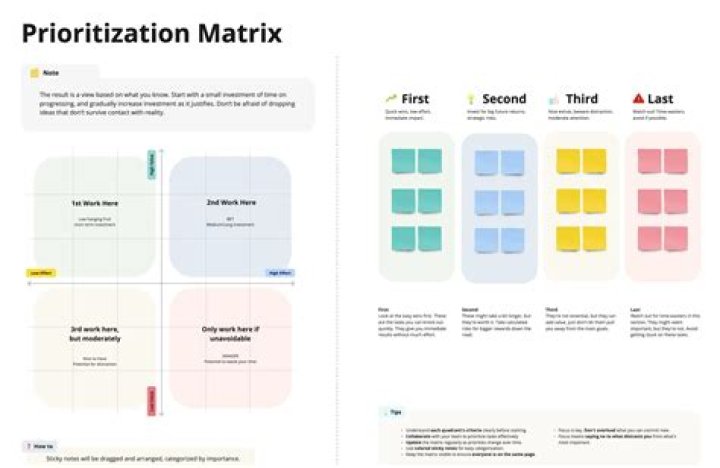
Vous ne pouvez pas tester tout. Il faut prioriser. Une méthode efficace consiste à estimer l’impact potentiel sur le KPI principal et la facilité d’exécution. Les changements rapides qui améliorent directement le parcours clé deviennent vos “quick wins”.
Ajoutez aussi une dimension de risque. Certaines modifications sont “propres” (elles touchent une micro-zone), d’autres sont plus systémiques. En combinant impact, effort et risque, vous construisez un backlog plus réaliste et vous augmentez le taux de réussite global.
Itérer en cycles : du test à la diffusion, puis à la mesure
Un cycle d’itération cohérent ressemble souvent à ceci : (1) diagnostiquer via les KPI, (2) formuler une hypothèse, (3) exécuter un test A/B, (4) apprendre et décider, (5) appliquer et re-mesurer. Cela garantit que chaque amélioration est vérifiée et non supposée.
Le point clé est de maintenir une continuité de mesure. Si vous changez d’indicateurs entre les cycles, vous perdez la capacité de comparer. C’est une source fréquente d’incohérence lors d’une série de tests.
Exploiter les résultats : comment interpréter sans sur-réagir
L’un des dangers les plus fréquents est la sur-réaction : vous voyez une légère différence et vous concluez trop vite, ou vous ignorez une tendance parce qu’elle n’atteint pas un seuil arbitraire. Une interprétation rigoureuse commence par la lecture du KPI principal, puis par l’examen des segments et des KPI secondaires.
Regardez si l’effet est constant. Si la variante gagne uniquement sur un segment, vous pouvez décider de personnaliser plutôt que d’adopter partout. Cette nuance transforme un “test mitigé” en action utile.
Enfin, gardez une trace. Les apprentissages répétés finissent par créer un “système de connaissances” : quelles modifications fonctionnent, dans quelles conditions, et avec quelles limites.
Aligner l’équipe autour d’un langage commun KPI A/B et itérations
Les performances ne sont pas seulement un sujet produit ou data : elles sont aussi un sujet de collaboration. Sans langage commun, les discussions tournent autour d’opinions. Avec un cadre partagé, les échanges deviennent plus structurés et plus rapides.
Le langage commun repose sur des règles simples : un KPI principal par test, une hypothèse explicite, une segmentation cohérente, et un compte rendu standard après l’expérience. Ce sont ces éléments qui rendent les itérations moins coûteuses et plus fiables.
De plus, l’alignement réduit le risque de “fatigue d’expérimentation”. Quand l’équipe sait comment les résultats seront interprétés et utilisés, elle accepte plus facilement les tests neutres ou perdants : ils font partie de la trajectoire d’amélioration.
Final Thoughts
Pour mesurer et améliorer vos performances sur faklum, l’essentiel est de construire une boucle d’amélioration robuste : des KPIs pertinents et actionnables, des tests A/B conçus pour produire des conclusions fiables, puis des itérations qui transforment chaque résultat en apprentissage. En appliquant cette méthode, vous évitez les décisions basées sur des intuitions et vous gagnez en vitesse, en clarté et en impact mesurable.
Sources [CDC - A/B testing et statistique appliquée (vue d’ensemble)](https://www.cdc.gov) [Google Analytics Academy - Métriques et mesure des performances](https://skillshop.withgoogle.com) [Microsoft - Guidance sur l’analyse de données et la prise de décision](https://www.microsoft.com) [NIST - Principes sur l’évaluation et la qualité des mesures](https://www.nist.gov)
Keep Learning
